


蚂蚁集团算法实习:流式长时视频生成与编辑、Prompt Control 与实时推理优化

实习背景
2026 年 5 月起,我在蚂蚁集团担任视频生成算法实习生,主要围绕
流式长时视频生成与编辑(Streaming Long Video Generation & Editing)
开展研发工作。
传统视频生成模型通常面向固定长度视频进行离线生成,当生成时间继续延长,或者希望在生成过程中动态修改内容时,会逐渐暴露出几个问题:
- 固定时间窗口限制,难以持续向后生成;
- 跨 Chunk 生成时容易出现内容跳变和长时 Drift;
- 新 Prompt 需要经过较长 Buffer 才能作用于输出;
- V2V 场景还需要同时保持原视频结构、编辑语义和时间连续性;
- 多步扩散 / Flow Matching 推理速度较慢,难以满足实时交互需求。
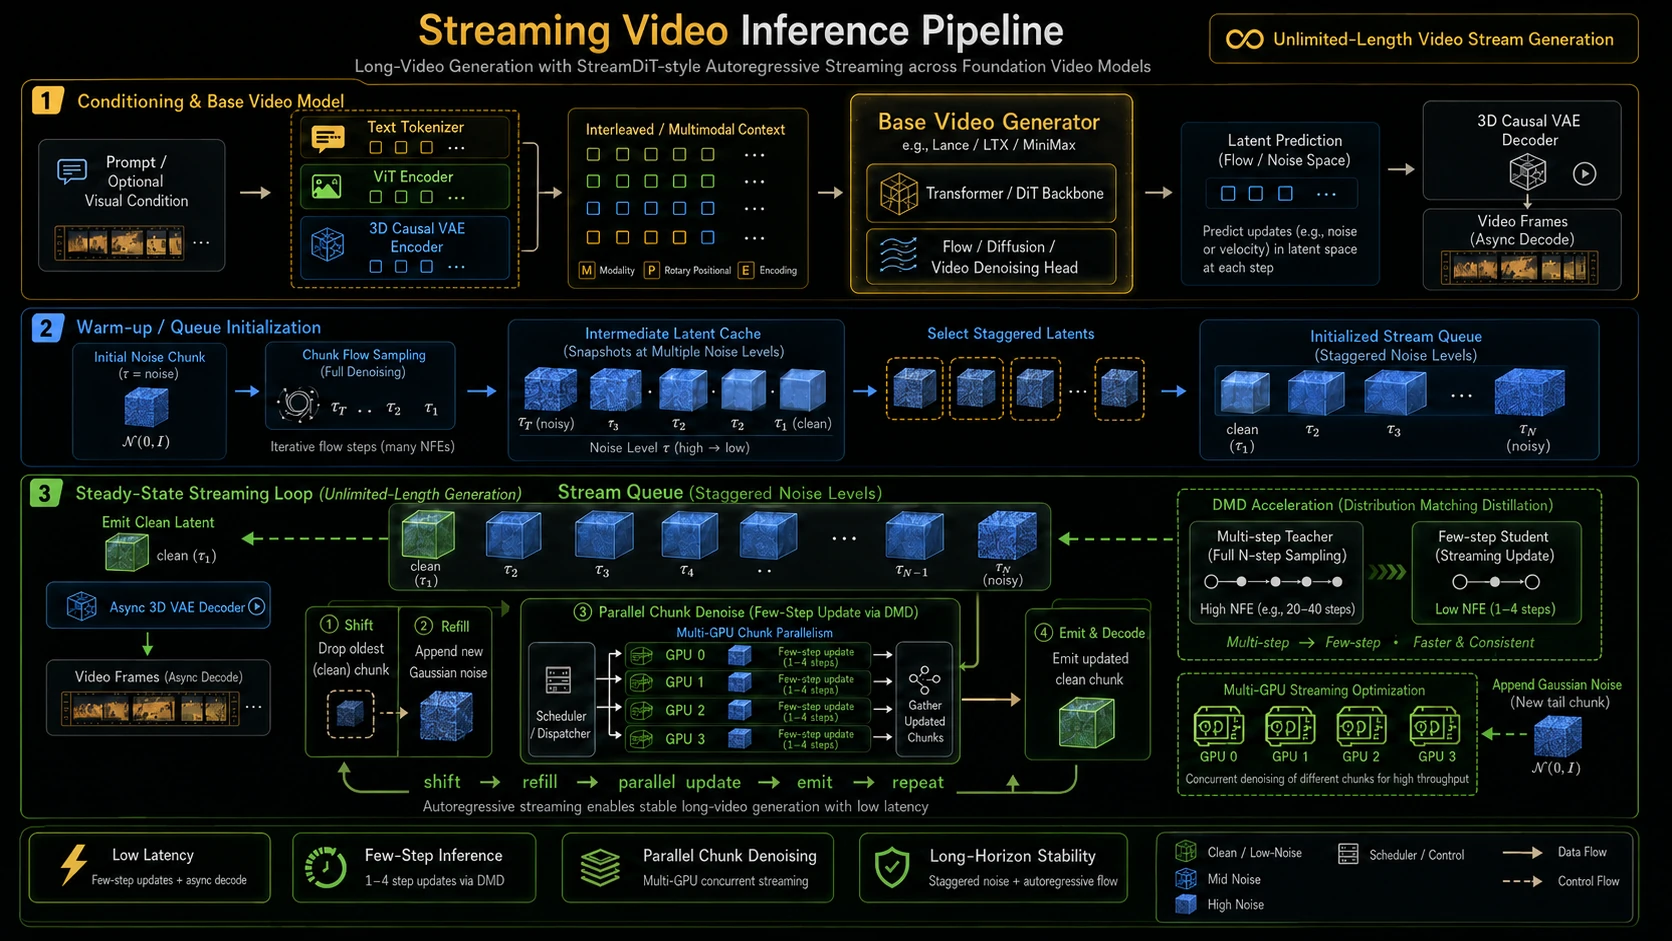
因此,我的工作主要沿着一条主线展开:
流式长时视频生成 ↓Streaming Prompt Control ↓Streaming V2V 视频编辑 ↓DMD + Multi-GPU 实时推理Lance 和 LTX 主要作为不同的视频生成基模,用于验证这些 Streaming 方法的有效性与可迁移性,而不是分别设计两套独立方案。
最终希望实现的是:
一个能够持续生成、持续编辑、动态响应用户指令,并进一步具备实时交互能力的视频生成系统。
流式长时视频生成
如果直接将离线的视频生成模型应用于长时视频生成,通常会出现严重的Drifting和误差累积等问题
可以看到如果直接拿离线模型生成长视频,前半段还算正常,但6s后就会出现明显的内容跳变和噪声累积。
流式长视频生成的核心,是将原本一次性完成的固定长度视频去噪,改造成可以持续运行的:
Stream Queue + Chunk Denoising
框架。
整个过程分别包含训练和推理两个阶段。
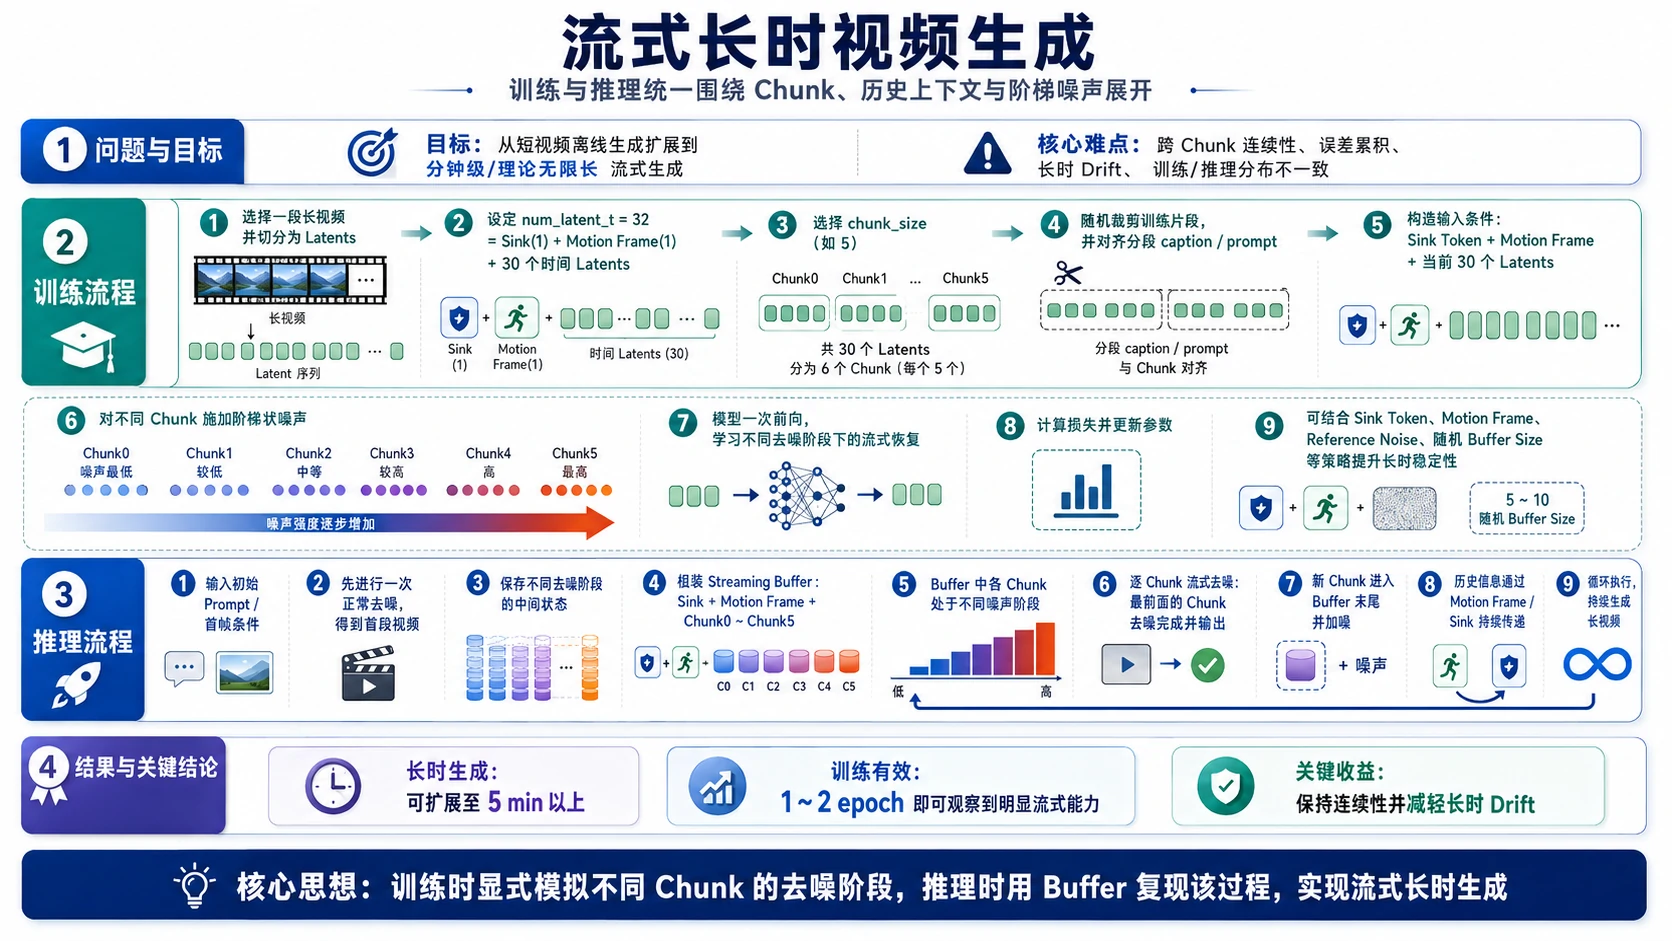
Streaming Training
假设模型时间维输入长度为:
num_latent_t = 32其中包含:
Sink Token 1 LatentMotion Frame 1 LatentVideo Latents 30 Latents当:
chunk_size = 5时,30 个 Video Latents 可以划分为 6 个 Chunk:
Sink | Motion | Chunk0 | Chunk1 | Chunk2 | Chunk3 | Chunk4 | Chunk5Streaming Training 的关键不是让所有 Chunk 使用相同噪声,而是显式模拟真实流式推理时:
不同 Chunk 同时处于不同去噪阶段。
例如可以构造:
Chunk0 Chunk1 Chunk2 Chunk3 Chunk4 Chunk5 ↓ ↓ ↓ ↓ ↓ ↓低噪声 较低 中等 较高 高 高噪声也就是沿 Stream Queue 形成一组阶梯状噪声。
训练流程可以概括为:
长视频 ↓VAE Latent ↓随机裁剪训练片段 ↓对齐对应 Caption / Prompt ↓选择 Chunk Size ↓划分多个 Chunk ↓分别施加不同等级的阶梯噪声 ↓Sink + Motion Frame + Noisy Chunks ↓模型 Forward ↓学习不同去噪阶段下的 Chunk Recovery同时结合 Sink Token、Motion Frame、Reference Noise、长视频 Random Crop 等机制,使模型能够在有限时间窗口中持续利用历史信息。
Streaming Inference
推理阶段需要复现训练阶段的阶梯噪声状态。
首先根据初始 Prompt 正常完成一次视频去噪,同时保留不同去噪阶段对应的中间状态:
Noise ↓Step 1 ↓Step 2 ↓... ↓Clean Video随后从这些状态中取出不同 Noise Level 的 Latent,组成初始 Stream Queue:
Sink | Motion | Chunk0 | Chunk1 | Chunk2 | Chunk3 | Chunk4 | Chunk5 ↓ ↓ ↓ ↓ ↓ ↓ Clean Low Mid High Higher Noise之后进入循环:
Denoise ↓最前端 Chunk 完成去噪 ↓Emit 输出 ↓Queue Shift ↓历史信息更新 ↓新的高噪声 Chunk 加入队尾 ↓继续 Denoise ↓Repeat即:
Denoise → Emit → Shift → Refill → Repeat通过不断复用固定长度的 Stream Queue,模型不需要重新处理完整历史视频,从结构上摆脱固定总视频长度的限制。
长时稳定性
Streaming 架构跑通后,真正困难的问题变成:
如何让几十秒、几分钟之后的视频仍然保持稳定?
早期实验中主要出现两类现象:
- 跨 Chunk 周期性内容跳变;
- 长时间生成后主体、背景逐渐 Drift,最终出现明显噪声累积。
后续主要从历史条件和训练 / 推理分布一致性两方面进行优化:
- 使用历史 Clean Frame / Motion Frame 为后续 Chunk 提供连续上下文;
- 引入 Sink Token 保留长期全局语义;
- 调整 Motion Frame 的输入与输出职责,减少周期性内容跳变;
- 对长视频进行 Random Crop,避免模型只学习视频开头;
- 对不同 Chunk、历史条件和 Reference 引入更符合流式推理过程的噪声设计。
在 Lance 上,模型从原本只能生成约数秒的视频逐渐扩展到分钟级持续生成,目前可以稳定生成较长视频,Streaming 结构本身可以继续向后运行。
在 LTX 上也观察到了类似结果:经过 Streaming Training 后,约 2 分钟视频后半段的主体和场景 Drift 明显小于原始权重,说明这种流式训练方式并不局限于单一基模。
Streaming Prompt Control
长视频能够持续生成之后,还存在一个问题,就是模型响应prompt的时间过慢。
如上视频所示,Prompt变换后通常需要十几秒甚至几十秒才能有所响应
因此,下一步是让模型具备:
生成过程中实时接收新的 Prompt,并修改后续视频内容。
例如:
白天 ↓黑夜 ↓下雨 ↓海啸而不是每次修改 Prompt 都重新启动一次视频生成。
Streaming Prompt Control 最主要的问题是:
新的 Prompt 输入以后,为什么不能立刻改变下一帧?
原因在于 Stream Queue 中同时存在多个已经部分去噪的 Chunk。
例如:
Prompt 1 ↓
Sink | Motion | Chunk0 | Chunk1 | Chunk2 | Chunk3 | Chunk4 | Chunk5 ↑ ↑ ↑ ↑ ↑ ↑ 已经携带不同程度的 Prompt 1 信息当 Prompt 2 输入时,这些 Chunk 并不会瞬间消失,因此新 Prompt 需要逐步穿过整个 Queue,最终才会反映到输出视频。
这形成了一个很明显的 Trade-off:
Buffer 长→ 上下文丰富→ 视频连续性好→ Prompt 响应慢
Buffer 短→ Prompt 响应快→ 历史信息不足→ 视频连续性下降针对这一问题,目前主要设计了两条方案。
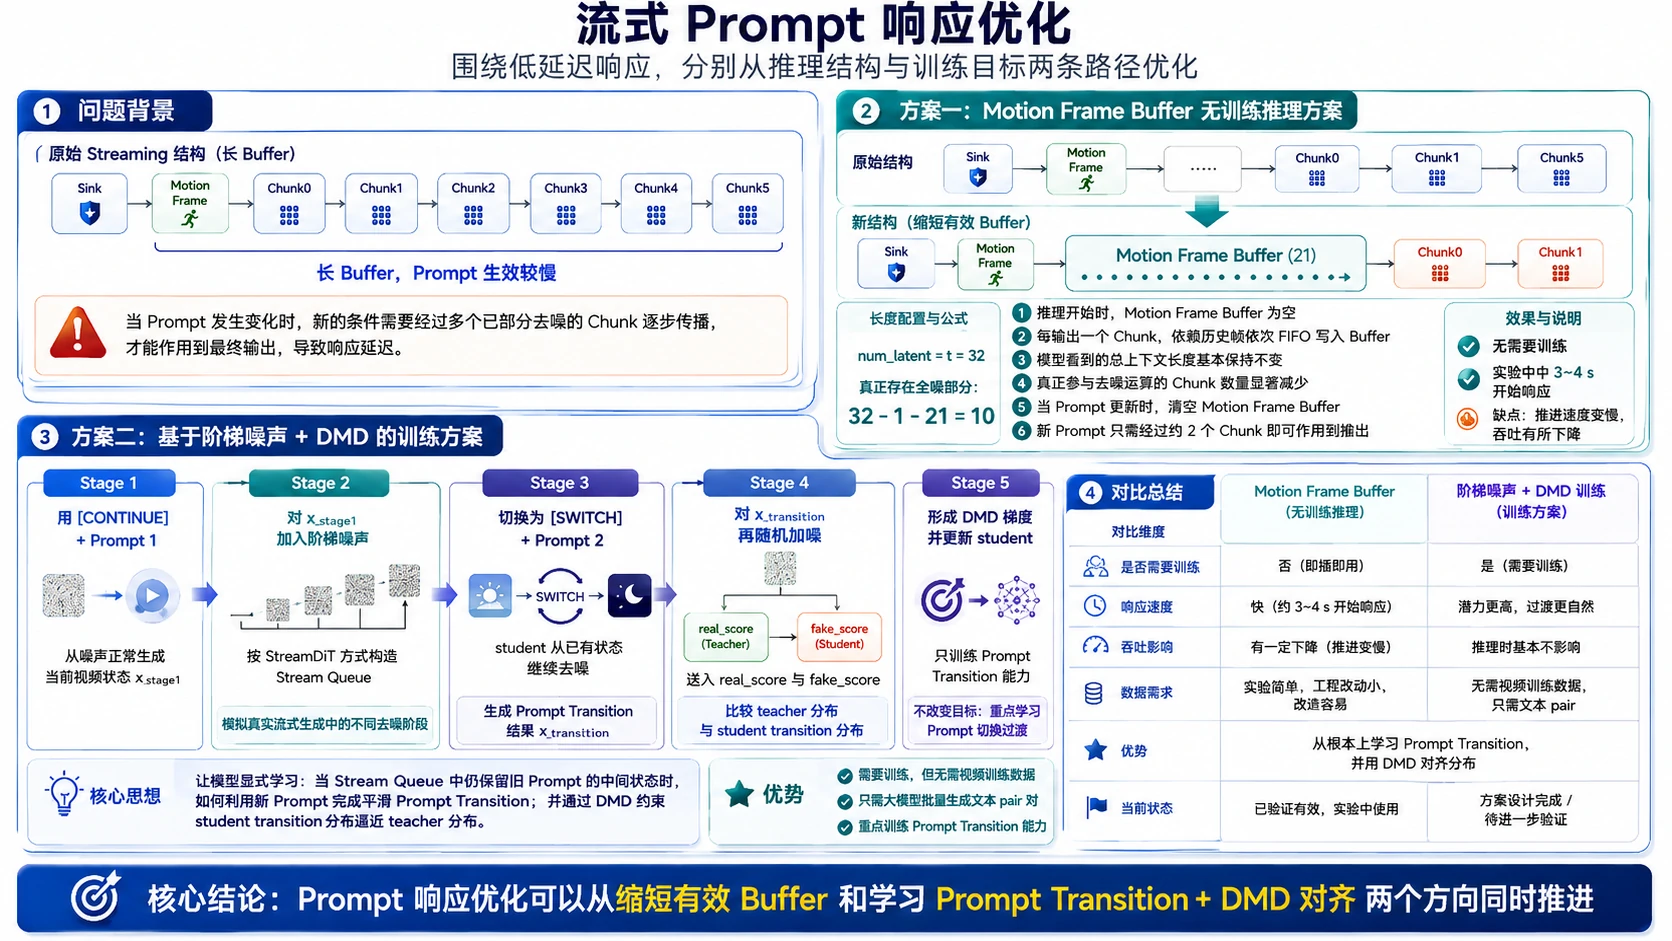
Motion Frame Buffer:无需训练的 Prompt 响应加速
第一种方案完全修改推理结构,无需重新训练模型。
原始 Streaming 输入为:
num_latent_t = 32
Sink | Motion | Chunk0 | Chunk1 | Chunk2 | Chunk3 | Chunk4 | Chunk5其中:
Sink = 1Motion Frame = 1Streaming = 30 Latents当 chunk_size = 5 时,相当于有:
6 个待去噪 Chunk新的 Prompt 因此需要经过较长的 Stream Queue。
我的思路是:
保持模型看到的总历史长度基本不变,但减少真正处于去噪状态的 Chunk 数量。
具体增加一个:
Motion Frame Buffer
例如设定:
Motion Frame Buffer = 21 Latents新的输入结构变成:
Sink | Motion | Motion Frame Buffer | Chunk0 | Chunk1 ← Clean Historical Latents → ← Noise →此时模型看到的时间上下文仍然接近原来的 32 个 Latents,但真正处于 Streaming Denoising 状态的只剩:
32 - 1 - 21 = 10 Latents当:
chunk_size = 5时,也就是:
2 个 ChunkFIFO 历史更新
Motion Frame Buffer 初始为空。
随着视频不断生成,每输出一个新的 Chunk,就把其中的历史 Clean Frame 按照 FIFO 的方式写入 Motion Frame Buffer:
输出 Chunk ↓提取历史 Clean Latents ↓写入 Motion Frame Buffer ↓最旧历史被移出 ↓保持固定长度因此虽然真正参与阶梯去噪的 Chunk 数量减少了,但模型仍然能够看到较长的历史视频。
Prompt Switch
当用户修改 Prompt 时:
Prompt 1 ↓[SWITCH] ↓Prompt 2此时直接清空 Motion Frame Buffer:
Clear Motion Frame Buffer避免模型继续大量参考 Prompt 1 对应的历史内容。
之后再由 Prompt 2 生成的新内容逐渐重新填入 Buffer。
这样,新 Prompt 不再需要经过 6 个 Chunk,而只需要经过约 2 个 Chunk 就能够完整作用于输出。
实验中可以做到:
30 s 输入新 Prompt,约 3~4 s 后开始出现明显响应。
这一方案的主要优势是:
- 无需训练;
- 可以直接应用于已有 Streaming Checkpoint;
- 仍然保留较长历史上下文;
- 显著缩短 Prompt 的有效传播路径。
代价是活跃 Streaming Chunk 数量减少以后,每轮能够向前推进的视频长度下降,因此整体生成吞吐也会有所降低。
这一点与后面的少步蒸馏具有较强的互补性:
Motion Frame Buffer ↓缩短 Prompt Buffer +
DMD Distillation ↓减少单 Chunk 去噪步数 ↓
低延迟 + 长上下文 + 高吞吐DMD Prompt Transition:学习如何切换 Prompt
Motion Frame Buffer 是从推理结构缩短 Prompt 生效路径。
另一条路线则是:
直接让模型学习“Prompt Transition”本身。
这里同样使用 DMD,但需要特别区分:
这里的 DMD 不是为了减少采样步数,而是为了训练 Streaming Prompt Transition 能力。
整个训练过程分为五个阶段。
Stage 1:生成当前视频状态
首先使用:
[CONTINUE] + Prompt 1从普通噪声开始正常生成当前视频:
Noise ↓Student ↓x_stage1其中 x_stage1 表示当前 Prompt 1 对应的视频状态。
Stage 2:构造真实 Streaming Queue
对 x_stage1 不直接重新从纯噪声生成,而是按照 Streaming 推理时的方式重新加入阶梯噪声:
x_stage1 ↓
Chunk0 Chunk1 Chunk2 Chunk3 Chunk4 Chunk5 ↓ ↓ ↓ ↓ ↓ ↓Clean Low Mid High Higher Noise得到一个模拟真实 Streaming 状态的 Stream Queue。
此时 Queue 中仍然保留 Prompt 1 产生的中间状态。
Stage 3:切换到新的 Prompt
然后输入:
[SWITCH] + Prompt 2让 Student 不从头生成,而是从已有 Streaming Queue 状态继续去噪:
Stream Queue from Prompt 1 +[SWITCH] + Prompt 2 ↓ Student ↓ x_transitionx_transition 就是 Student 当前生成出来的 Prompt Transition 结果。
例如:
Prompt 1:白天城市
↓ SWITCH
Prompt 2:夜晚城市
↓
白天 → 黄昏 → 夜晚Stage 4:DMD Distribution Matching
得到 x_transition 后,再对它进行一次 DMD 随机加噪:
x_transition ↓Random Noise Level ↓x_t随后分别送入:
real_score与:
fake_score其中:
real_score→ 描述 Teacher 目标分布
fake_score→ 描述当前 Student Prompt Transition 分布比较二者对当前 noisy sample 的预测差异。
直观理解就是:
Teacher 认为一个自然的 Prompt 2 视频应该朝哪个方向恢复,而 Student 当前生成出来的 Transition 又位于什么分布。
Stage 5:只更新 Prompt Transition 能力
利用:
real_score - fake_score形成 DMD Gradient,并更新 Student。
因此训练目标不是:
30 step → 6 step而是:
Student Transition Distribution ↓逼近 ↓Teacher Distribution也就是只重点训练:
当 Streaming Queue 中仍然保留 Prompt 1 的状态时,模型如何响应 Prompt 2,并自然完成语义转换。
完整流程可以概括为:
[CONTINUE] + Prompt 1 ↓生成 x_stage1 ↓构造阶梯噪声 Stream Queue ↓[SWITCH] + Prompt 2 ↓Student Streaming Denoising ↓生成 x_transition ↓随机加噪 ↓real_score / fake_score ↓DMD Gradient ↓Update Student ↓学习 Prompt Transition这个方案还有一个比较重要的优势:
不依赖真实 Prompt Transition 视频训练数据。
训练过程中只需要构造:
Prompt 1 → Prompt 2的文本 Pair。
例如可以直接通过大语言模型批量生成:
白天城市 → 夜晚城市
晴天森林 → 暴雨森林
普通人物 → 钢铁侠
平静海面 → 海啸场景视频状态本身可以由 Teacher / Student 在线生成,因此不需要人工采集大量:
Prompt 1 状态 → Prompt 2 状态对应的真实渐变视频。
这使得 Prompt Transition 训练数据可以较低成本地扩展。
Streaming V2V 视频编辑
除了 T2V Streaming 和 Prompt Control,另一项重要目标是:
Streaming Long Video-to-Video Editing
也就是:
输入一段持续到来的原视频,在保持主体、动作和整体时序结构的同时,根据编辑 Prompt 持续修改视频内容。
相比 T2V,Streaming V2V 的条件更加复杂:
Source Video +Editing Prompt +Historical Generated Video +Current Stream Queue ↓Edited Streaming Video模型既要理解原视频,也要保证:
- 原视频主体结构尽可能保持;
- Prompt 编辑效果足够明显;
- 跨 Chunk 不出现明显跳变;
- 编辑效果不会随着时间逐渐消失;
- 长时间运行后仍然保持稳定。
目前 Lance 和 LTX 上的 Streaming V2V 仍在继续补充实验,因此现阶段主要完成了 V2V 数据和训练 Pipeline 的准备。
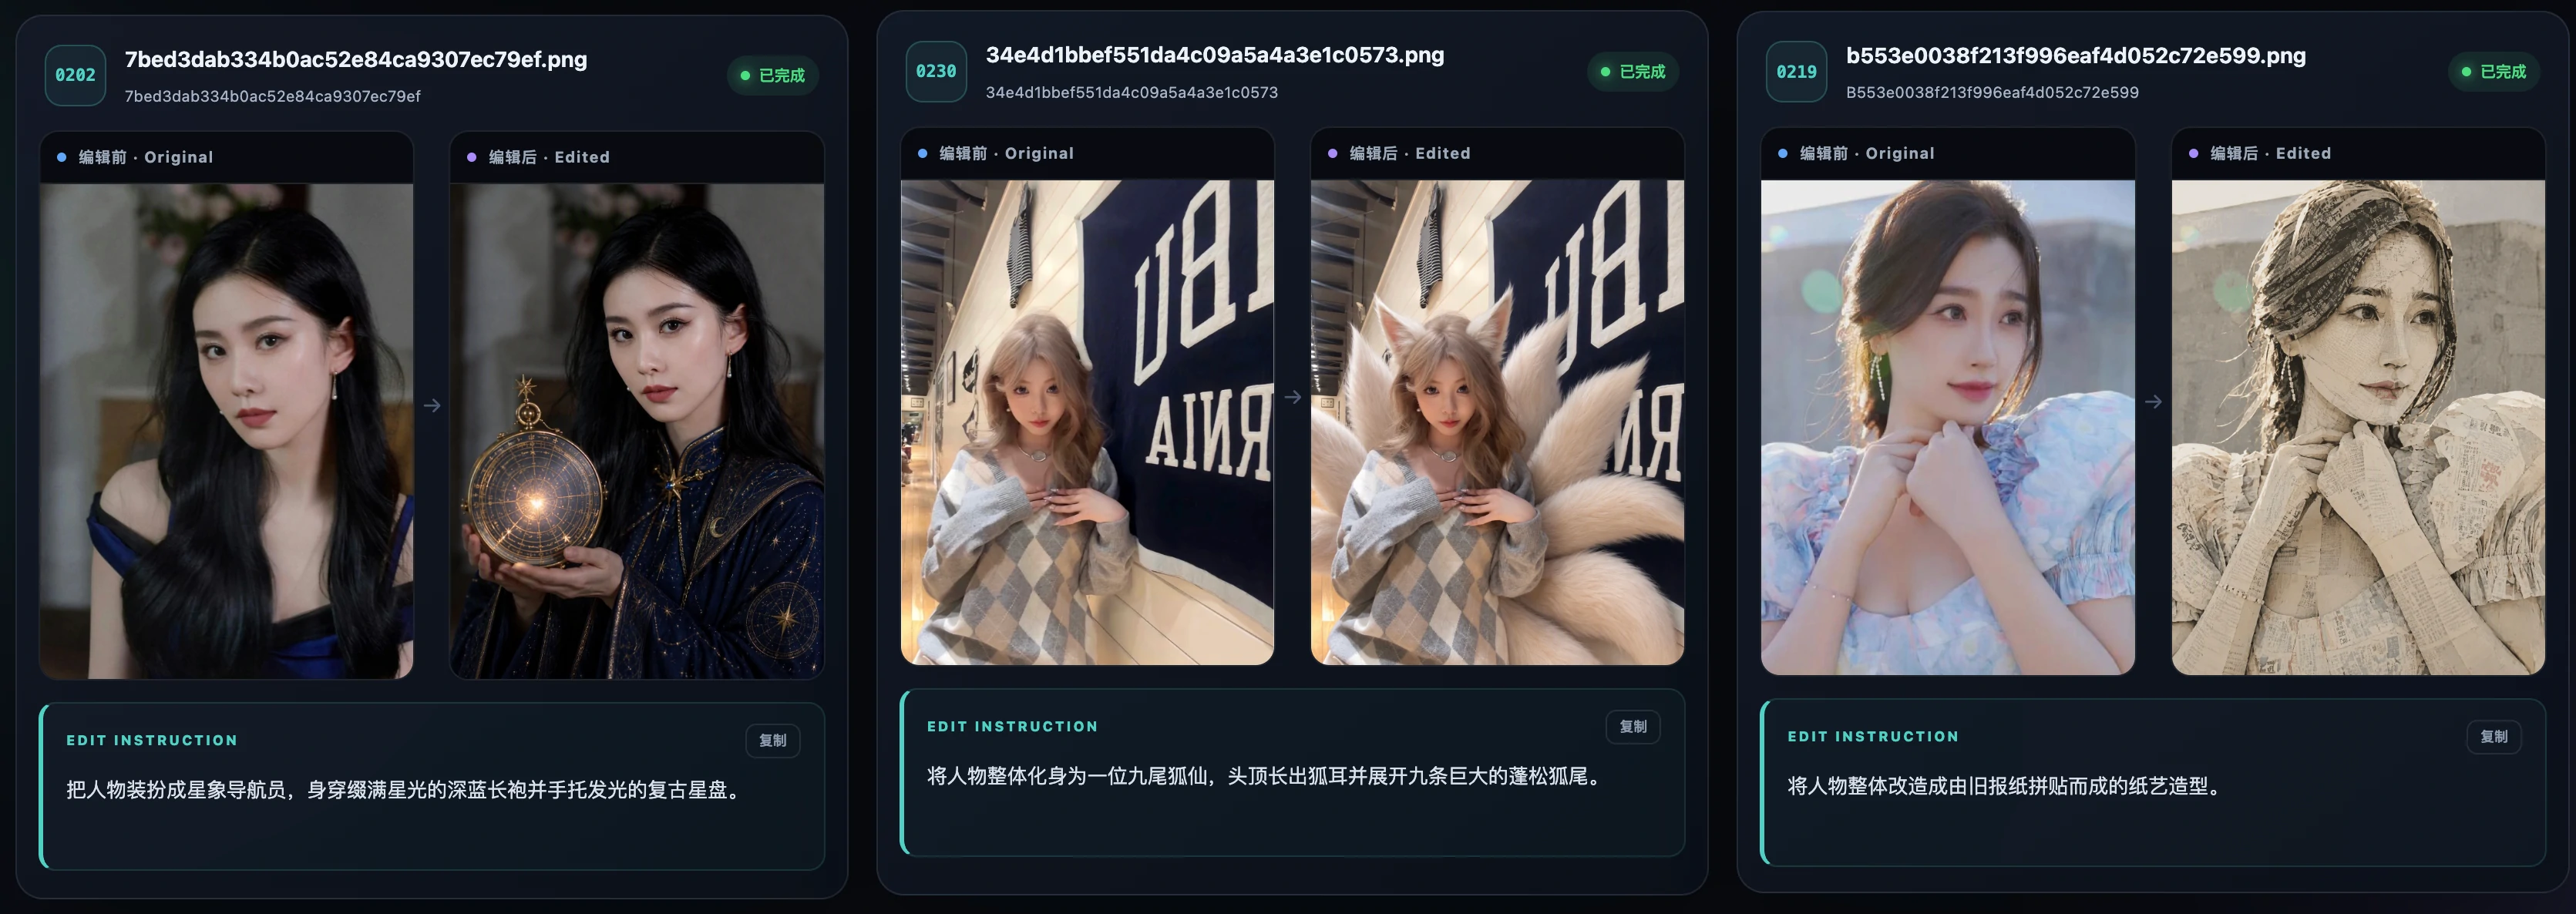
50 万规模高质量编辑数据:为 V2V 服务
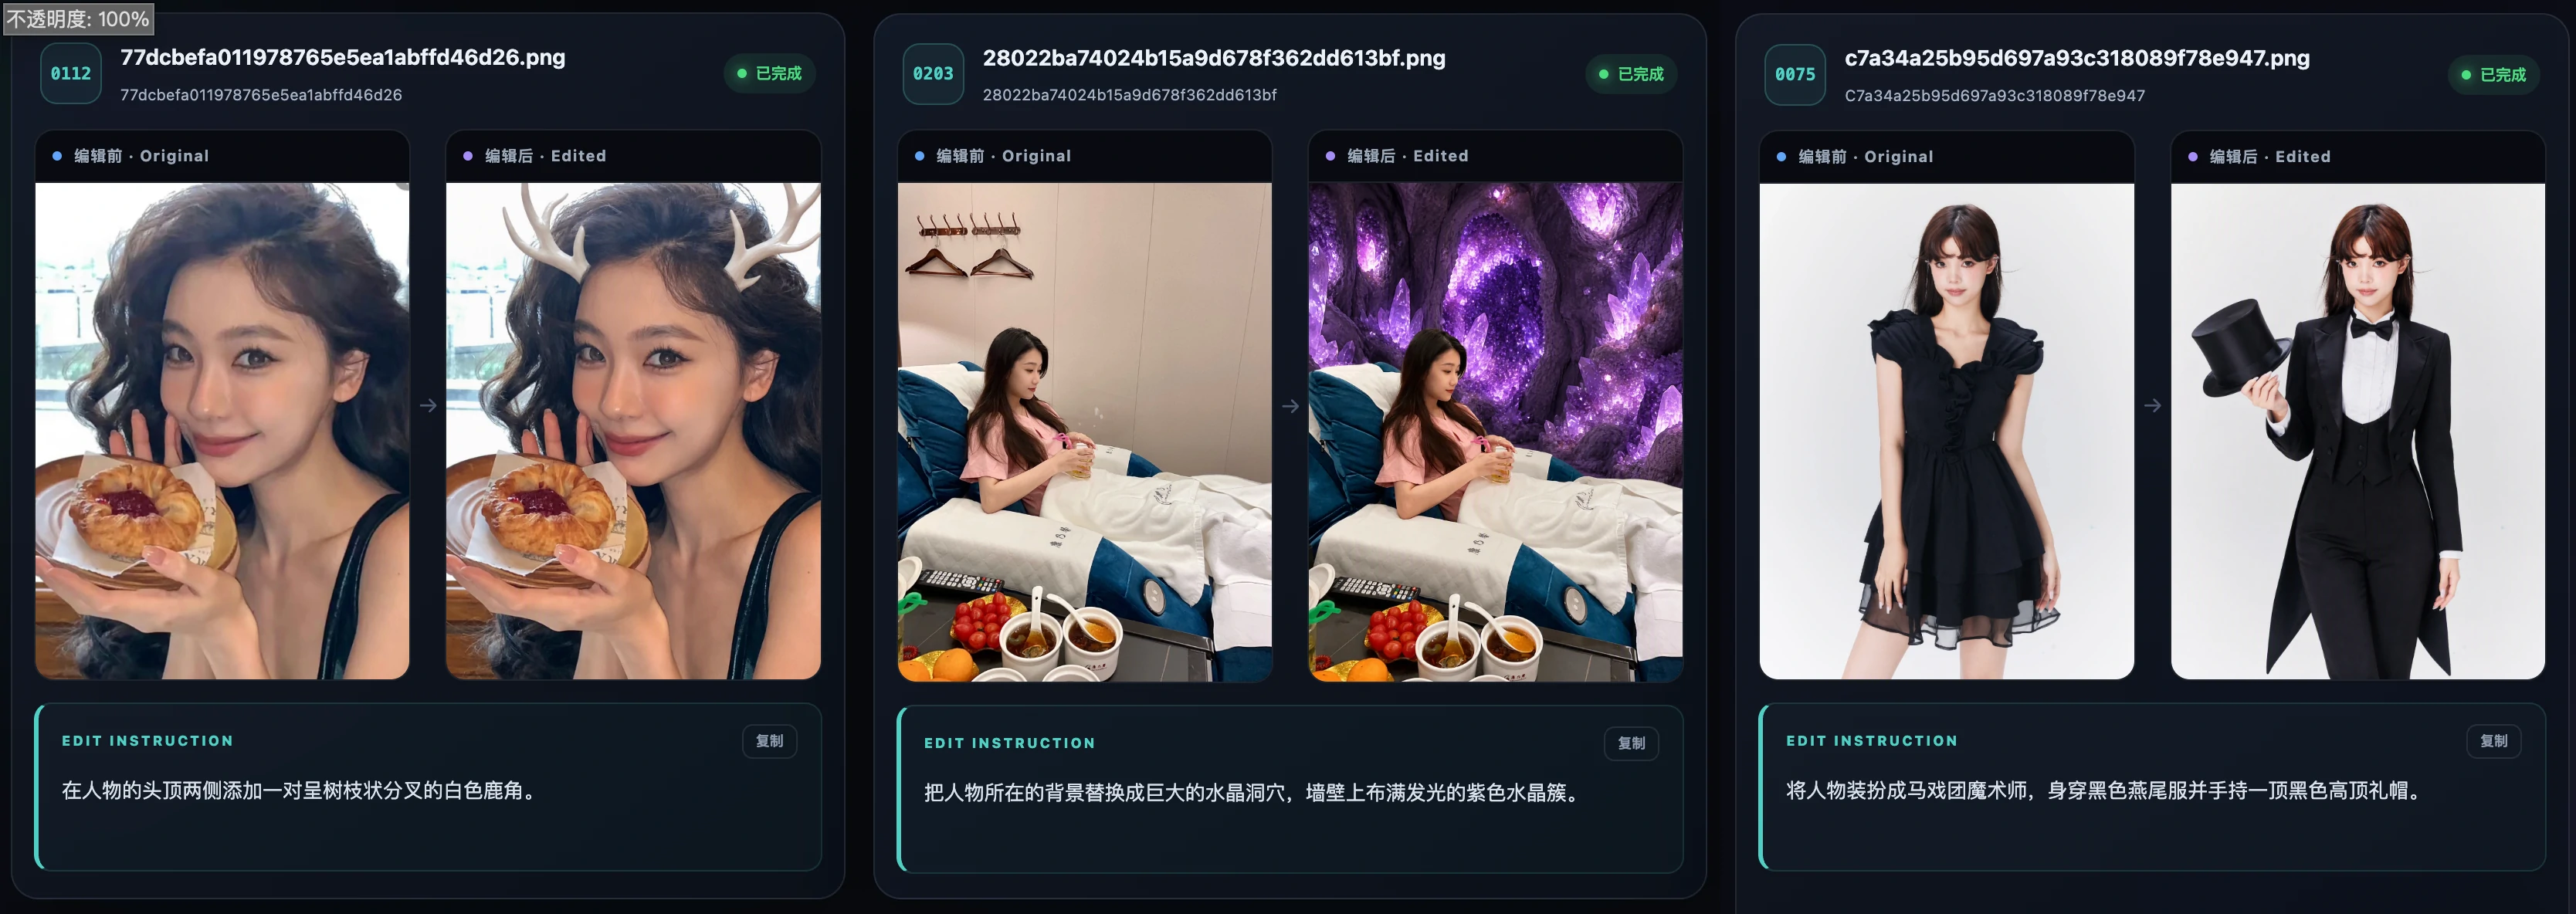
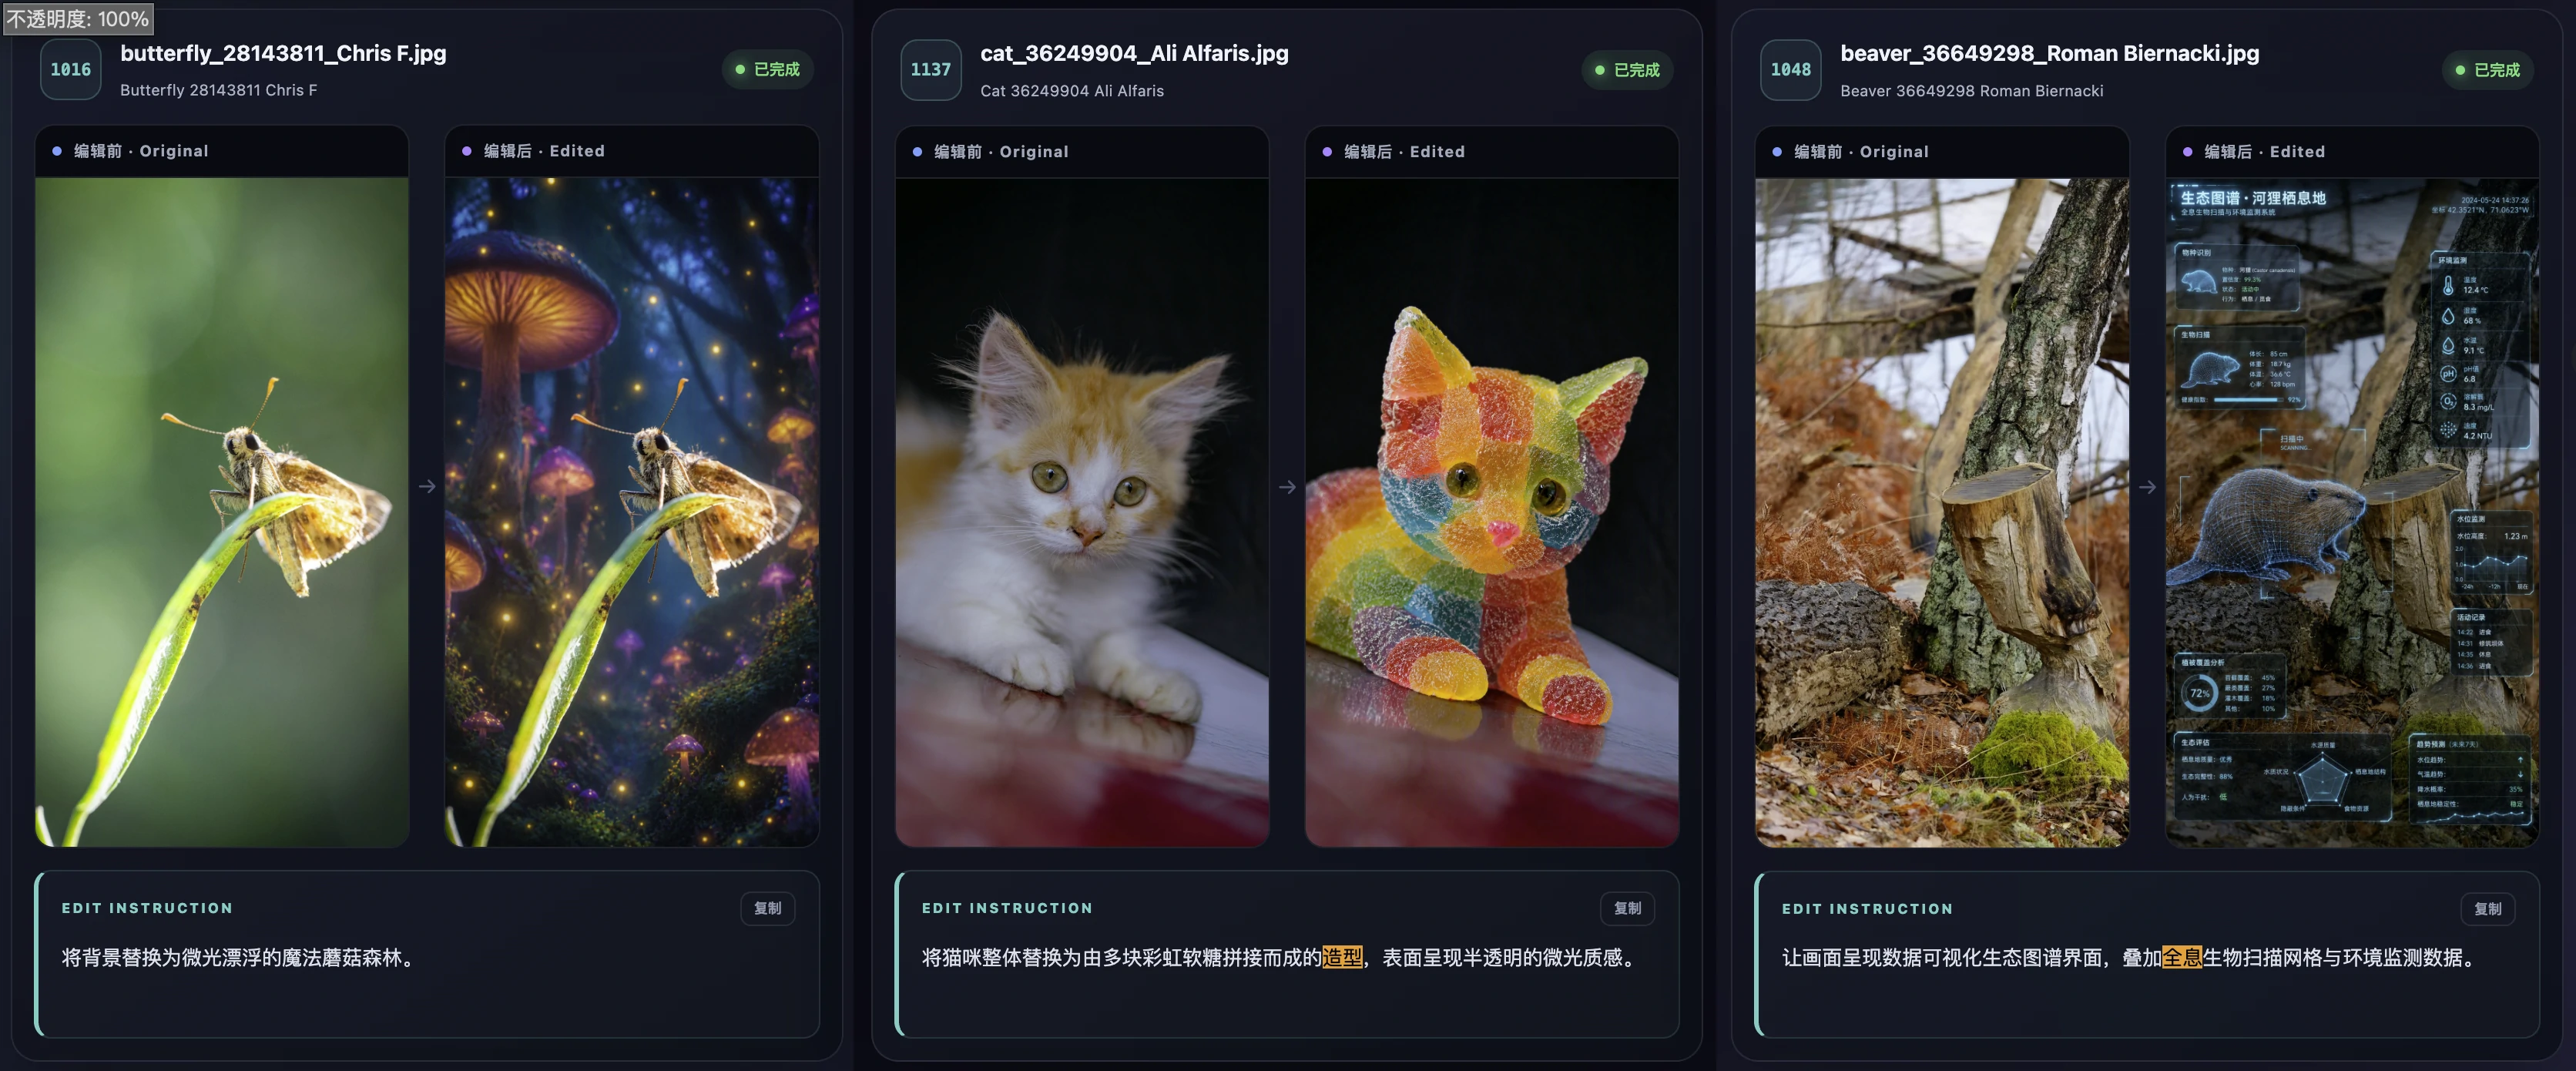
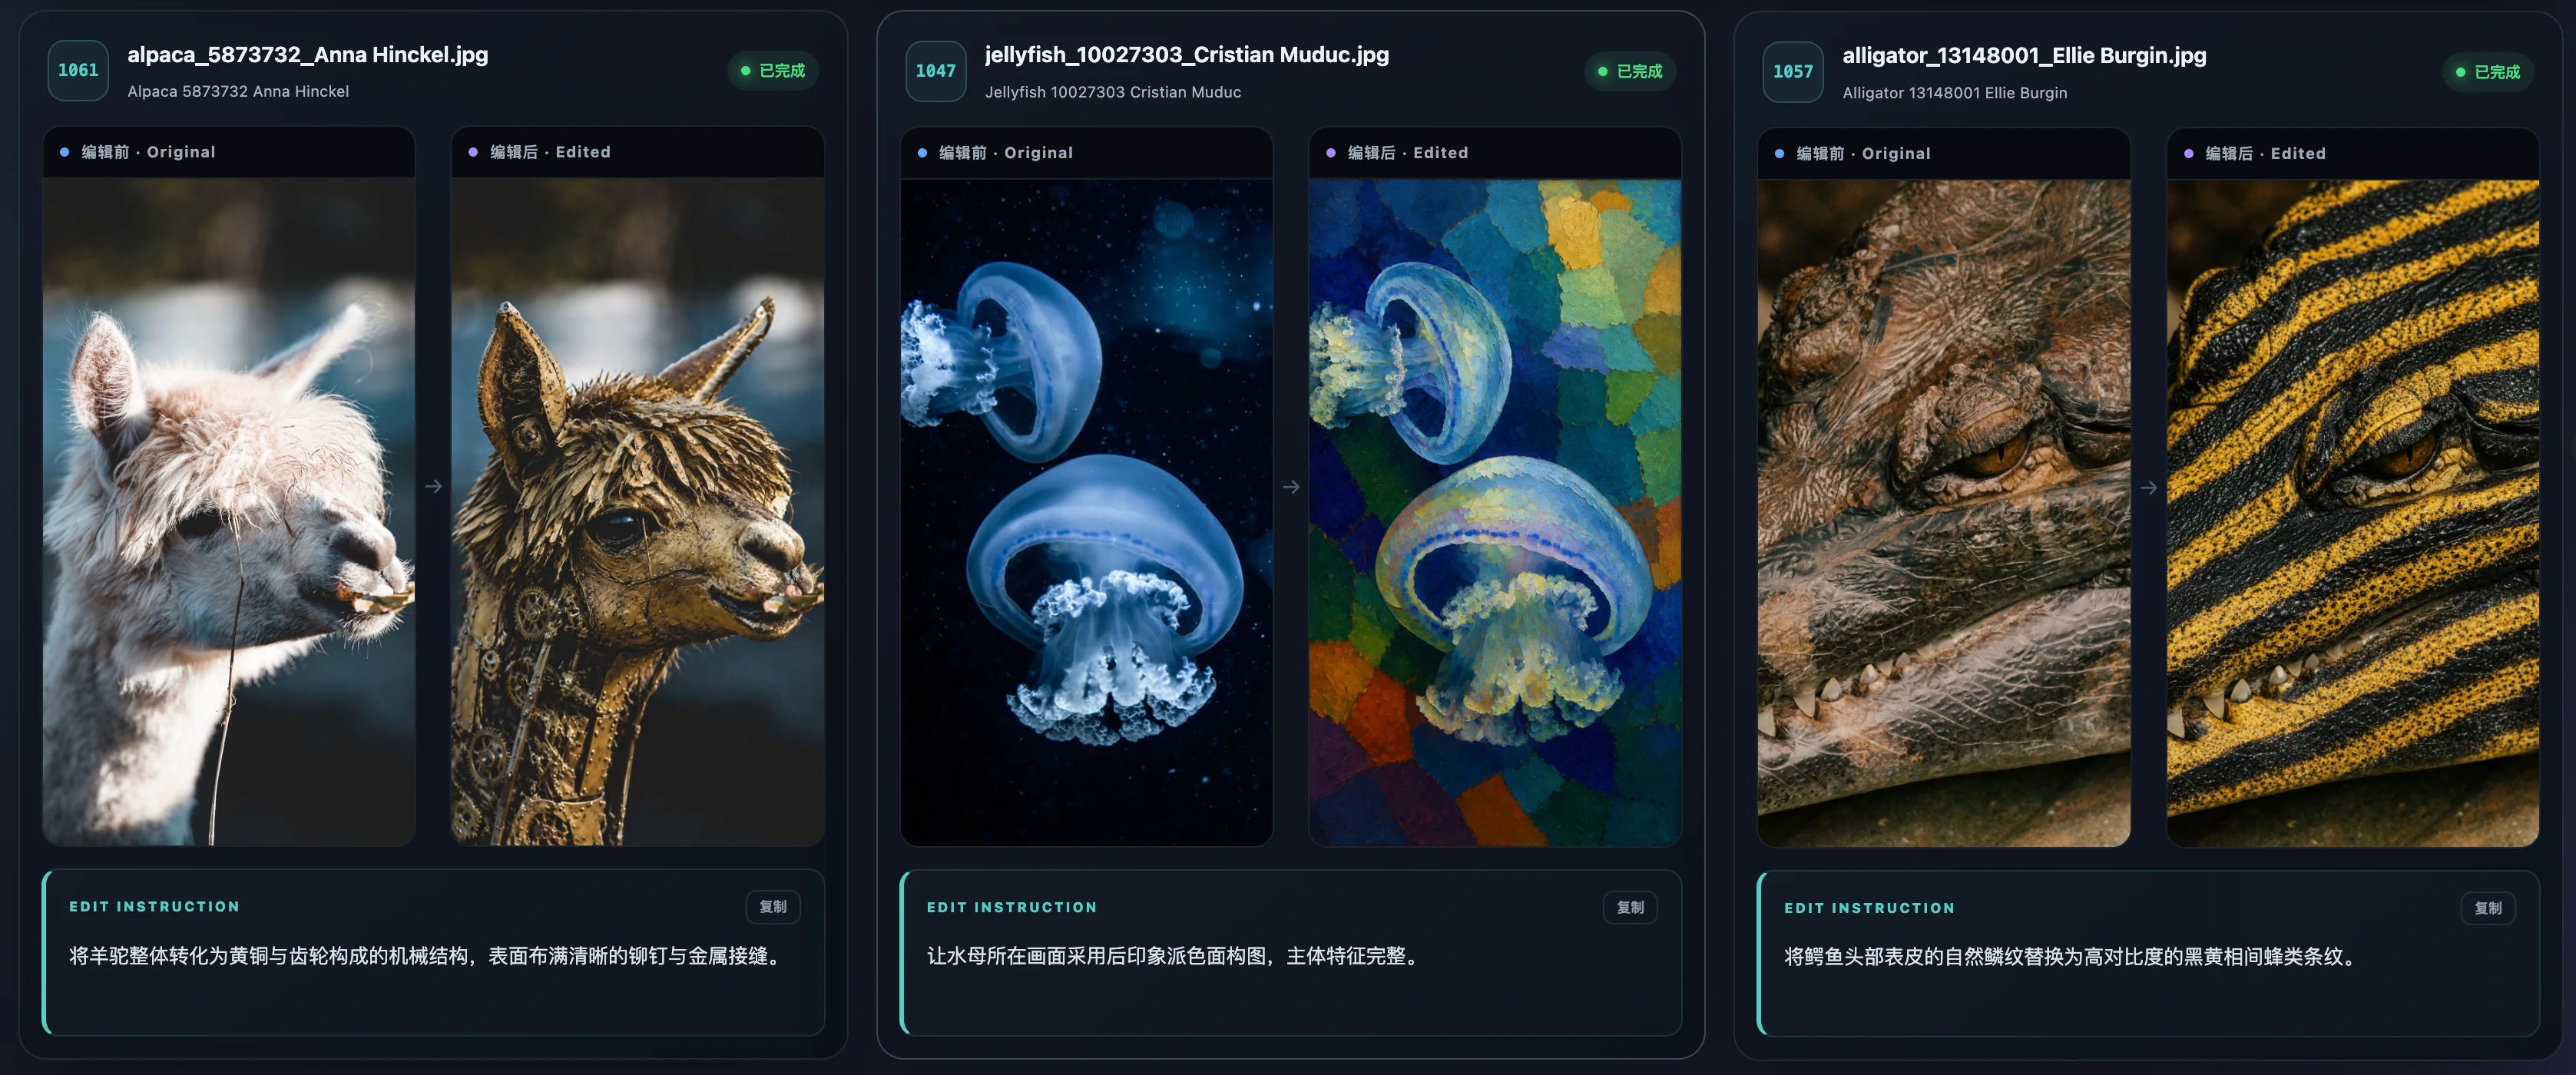
为了进一步训练视频编辑能力,我构建了约 50 万对高质量指令式图像编辑数据。
这部分工作并不是独立的数据集项目,而是服务于后续:
Image Editing → Video Editing → Streaming V2V
能力扩展。
整体数据生产流程包括:
原始图像采集 ↓分辨率 / 内容筛选 ↓Gemini 生成 Editing Prompt ↓Prompt 分类与 Case Sampling ↓GPT-Image-2 生成 Edited Image ↓Source / Prompt / Target 三元组展示 ↓VLM + 人工质量过滤 ↓高质量 Editing Pair数据覆盖人物、动物、场景和物体等多种类型。
其中重点关注:
- 编辑变化必须足够明显;
- Prompt 必须准确作用于目标主体;
- 编辑前后主体身份和结构尽可能稳定;
- 避免无意义的光线、气味等弱视觉变化;
- 避免比例、尺寸发生不必要的大幅变化;
- 减少明显 Artifact 与结构错位。
这些数据首先提供高质量:
Source Image +Editing Instruction ↓Target Image监督,使模型学习“什么应该保持、什么应该修改”。
后续再进一步加入时间维条件和 Streaming Queue,将编辑能力扩展到连续视频。
以下为部分编辑样例:
实时视频生成
完成 Streaming 后,另一个重要问题是:
如何让这个系统真正以接近播放速度的吞吐持续运行?
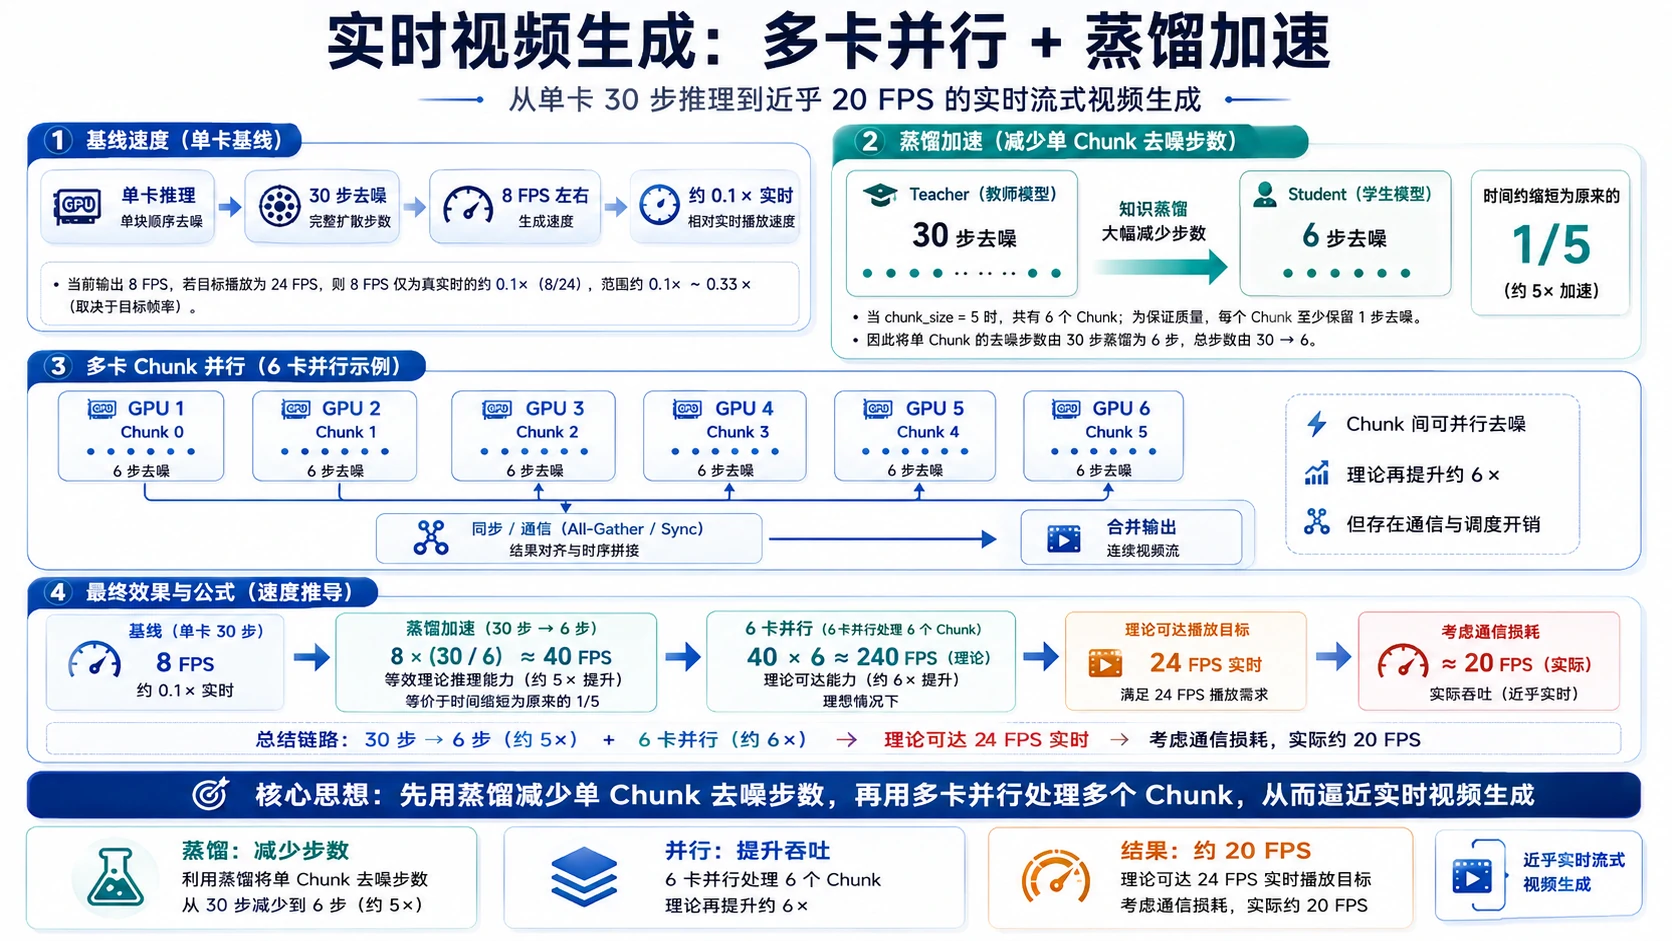
主要瓶颈仍然来自多步 DiT / Flow Matching Denoising。
当前默认采样约:
30 Steps输出视频本身为:
8 FPS这里需要区分两个概念:
- 8 FPS:生成视频的帧率;
- 约 0.8 FPS:初始单 GPU 30-step 配置下实际生成吞吐。
因此初始系统速度约为:
0.8 FPS≈ 0.1 × realtime实时化主要从两个维度推进:
减少单 Chunk 去噪次数 +多个 Chunk 并行计算DMD 少步蒸馏
这里再次使用 DMD,但和前面的 Prompt Transition DMD 目标不同。
这里的目标明确是:
减少 Sampling Steps,提高生成速度。
原始模型约需要:
30-step而默认 Stream Queue 中有:
6 个 Chunk当:
chunk_size = 5时,每个 Chunk 至少需要一次有效的 Denoising Update。
因此主要目标设定为:
30-step Teacher ↓DMD Distillation ↓6-step Streaming Student也就是:
30 → 6理论上将去噪时间缩短为原来的:
6 / 30 = 1 / 5约获得:
5×
的计算加速。
Multi-GPU Chunk Parallelism
Streaming 架构还天然暴露出了时间维上的并行性。
一个 Stream Queue 中:
Chunk0 | Chunk1 | Chunk2 | Chunk3 | Chunk4 | Chunk5不同 Chunk 同时存在,只是分别位于不同的 Noise Level。
在一次 Streaming Iteration 内,可以将它们分别放到不同 GPU 上:
GPU 0 → Chunk 0GPU 1 → Chunk 1GPU 2 → Chunk 2GPU 3 → Chunk 3GPU 4 → Chunk 4GPU 5 → Chunk 5各 GPU 并行完成当前 Chunk 对应的一次 Denoising Update:
GPU0 ─┐GPU1 ─┤GPU2 ─┤GPU3 ─┼→ Sync → Update Stream QueueGPU4 ─┤GPU5 ─┘随后统一同步 Queue 状态,再进入下一轮 Streaming Iteration。
这里利用的不是传统意义上的模型切分,而是 Streaming Video 本身产生的:
Chunk-Level Parallelism
因此在 6 个 Chunk 的配置下,理论上还可以进一步获得接近:
6×
的并行加速。
实际运行中需要考虑:
- GPU 间通信;
- Queue Scheduling;
- 数据同步;
- VAE Decode;
因此不会达到理想的线性加速。
从 0.1× Real-time 到约 20 FPS
整体实时推理优化链路为:
30-step Streaming ↓6-step DMD ↓6-GPU Chunk Parallelism ↓Async VAE Decode ↓Real-Time Streaming Video初始吞吐约:
0.8 FPSDMD 将:
30 → 6理论上约:
0.8 × 5 ≈ 4 FPS再使用 6 GPU 并行处理 6 个 Chunk:
4 × 6 ≈ 24 FPS因此理想情况下可以达到约:
24 FPS
的实时视频吞吐。
进一步考虑 GPU 通信、调度以及 VAE Decode 等工程开销后,最终实际吞吐约为:
20 FPS
也就是说,整个系统从最初约:
0.1× realtime逐步提升到接近实时运行。
这也是 Streaming 架构的重要价值之一:
它不仅解决“视频能不能持续生成”,同时还把原本串行的视频去噪过程拆解成可以进一步蒸馏和并行优化的计算结构。
视频增强
生成模型本身主要负责视频内容和实时生成能力。
显示侧还可以进一步使用独立的视频增强模块:
- FlashVSR:提高视频空间分辨率;
- RIFE:进一步提高播放帧率。
生成模型与后处理模块保持解耦,可以根据不同应用场景在实时性和视觉质量之间进行调整。
阶段性总结
整个实习围绕:
如何把离线视频生成模型变成可以持续运行、持续编辑并实时交互的视频生成系统
逐步推进。
整体能力链路可以概括为:
Fixed-Length Video Generation ↓Streaming Long Video Generation ↓Streaming Prompt Control ↓Streaming V2V Editing ↓DMD Distillation ↓Multi-GPU Parallelism ↓Real-Time Interactive Video Generation目前主要形成了以下几项阶段性结果:
1. Streaming Long Video
通过 Chunk-based Stream Queue、阶梯噪声训练和历史条件建模,将固定长度离线视频生成扩展到分钟级持续生成,并在 Lance / LTX 等不同基模上验证了 Streaming Training 对长时 Drift 的改善作用。
2. Streaming Prompt Control
实现运行过程中动态修改 Prompt,并围绕 Prompt 响应延迟进一步提出:
Motion Frame Buffer和:
DMD Prompt Transition两条互补路线。
前者从推理结构上缩短有效 Buffer,不需要重新训练;后者直接让模型学习如何从旧 Prompt 的 Streaming 状态自然过渡到新 Prompt,并且不依赖真实视频 Transition 数据。
3. Streaming V2V
围绕长时视频编辑继续扩展 Streaming 架构,并构建约 50 万规模的高质量 Editing Pair,为后续 V2V 指令理解和目标外观监督提供训练基础。
4. Real-Time Generation
通过:
30-step → 6-step DMD减少单 Chunk 计算量,再结合:
6-GPU Chunk Parallelism并行处理 Stream Queue,最终将生成吞吐从约:
0.8 FPS提升到约:
20 FPS逐步接近实时视频生成。
相比单纯提升一次视频生成的视觉质量,这段实习让我更关注的是:
生成模型如何从一个离线 Demo,真正演变成具有长时记忆、动态控制、视频编辑和实时推理能力的持续运行系统。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!